如何正确获取 MongoDB 集合里面的最后一条数据
在我们使用 Python 查询 MongoDB 的时候,一般会使用MongoDB 的集合(collection)对象的 find()方法或者find_one()方法:
1 | import pymongo |
其中,find()方法返回的是一个游标对象,我们可以直接对这个对象进行迭代,从而按顺序获取每一条数据。
在我们使用 Python 查询 MongoDB 的时候,一般会使用MongoDB 的集合(collection)对象的 find()方法或者find_one()方法:
1 | import pymongo |
其中,find()方法返回的是一个游标对象,我们可以直接对这个对象进行迭代,从而按顺序获取每一条数据。
你的代码是如何被炫技毁掉的?
Jupyter 是数据分析领域非常有名的开发环境,使用 Jupyter 写数据分析相关的代码会大大节约开发时间。
设想这样一个场景:别的部门的同事传给你一个数据分析的模块,用于实现对数据的高级分析。模块里面有上百个函数。
原来我们在 Python 中写日志,使用的是 Python 自带的 logging 模块,要实现既在终端输出,又能写文件,并且日志文件还能 rotate ,代码需要十多行:
1 | import logging |
那有没有什么简单好用,for human的写日志方案呢?
有这样一个业务场景:
我有100篇故事,放在 MongoDB 里面。我做了一个 web 接口,每次请求返回一篇故事。希望能够实现:
每次请求返回的故事都不一样,在100次请求里面,每篇故事都需要返回。直到100篇故事全部返回完成。第101次与第1次相同,第102次与第2次相同……
在我们日常使用 Python 时,大家可能有这样一种认识:
True,a is b 不一定为 TrueTrue,则 a == b 一定为 True1 | >>> a = 'abc!' |
这是因为 == 只比较值,而 is 同时比较值和内存地址。简单来说:你左手边有一个人,右手边有一个人,两个人长得一模一样,那么左手边的人==右手边的人;你左手边有一个人,一分钟以后这个人走到了你的右手边,那么刚才左手边的人 is 现在右手边的人
但凡事总有意外,情况下面的代码:
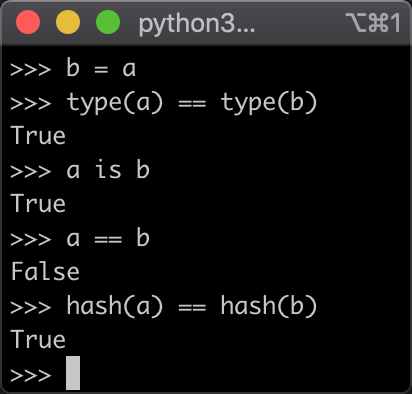
为什么会出现这种情况?a is b为 True,a == b却为 False。
你可以先停在这里,猜一下a 和 b 里面的值到底是什么东西。
现在来揭开答案,我们来网上看两行:
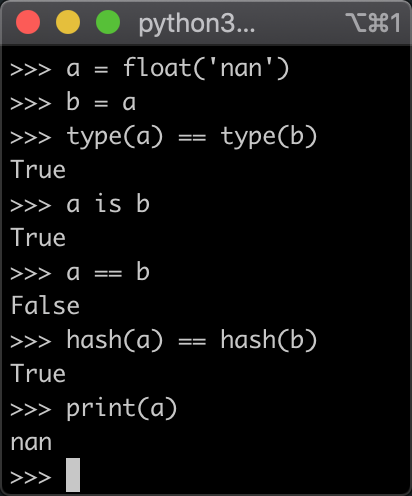
a 和 b 的值为♂,它的意思是Not a Number,非数。
♂与任何数,包括它自己比较,结果都是 False,这是IEEE-754规定的:
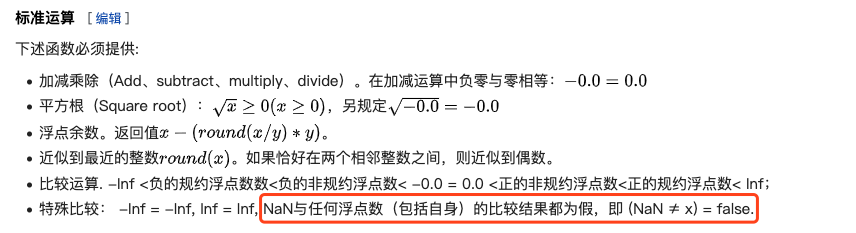
Python 在实现这个数据的时候,根据 IEEE-754的要求,也做了限制:
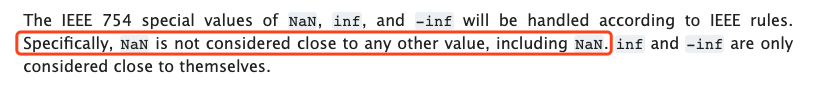
相关的文档地址详见 Python 的 math 库
所以,这里 a == b 为 False,是一种特殊情况。并不是 Python 出现了错误。
当我们使用 Elasticsearch-py 批量插入数据到 ES 的时候,我们常常使用它的 helpers模块里面的bulk函数。其使用方法如下:
1 | from elasticsearch import helpers, Elasticsearch |
但这种方式有一个问题,它默认相当于upsert操作。如果_id 对应的文档已经在 ES 里面了,那么数据会被更新。如果_id 对应的文档不在 ES 中,那么就插入。
在开发新闻网页正文通用抽取器GNE的过程中,需要对目标网页的源代码进行一些预处理,从而提高正文抓取的准确性。其中之一就是把 <p>标签内部的 <span>标签中的文本,合并到<p>标签中,再删除 <span> 标签。
开发这个项目,源自于我在知网发现了一篇关于自动化抽取新闻类网站正文的算法论文——《基于文本及符号密度的网页正文提取方法》)
这篇论文中描述的算法看起来简洁清晰,并且符合逻辑。但由于论文中只讲了算法原理,并没有具体的语言实现,所以我使用 Python 根据论文实现了这个抽取器。并分别使用今日头条、网易新闻、游民星空、观察者网、凤凰网、腾讯新闻、ReadHub、新浪新闻做了测试,发现提取效果非常出色,几乎能够达到100%的准确率。
在我以前的一篇文章:一日一技:如何正确移除Selenium中window.navigator.webdriver的值,我讲到了如何在Selenium启动的Chrome中,通过设置启动参数隐藏window.navigator.webdriver,驳斥了网上垃圾文章中流传的使用JavaScript注入的弊端。
由于Selenium启动的Chrome中,有几十个特征可以被识别,所以在爬虫界已经没有以前那么受欢迎了。模拟浏览器的新秀Puppeteer异军突起,逐渐受到了爬虫界的关注。Puppeteer需要使用JavaScript来控制,如果你是用Python,那么就需要使用Pyppeteer.
如果你使用模拟浏览器爬淘宝,你会发现,无论怎么修改参数,Selenium总是可以立刻被识别。但是如果你使用了本文的方法,用Pyppeteer抓取淘宝,你就会发现另外一个广阔的天地。
今天,我们来讲讲如何在Pyppeteer中隐藏window.navigator.webdriver