谢乾坤 | Kingname

给时光以生命。

最近 AI 圈又流行起了一种很有未来感的产品形态:AI 办公室。

打开软件,左边是一排员工。产品经理 Alice,前端工程师 Bob,后端工程师 Charlie,设计师 David,QA Eve。每个人都有头像、职位、自己的记忆,甚至还有一份 SOUL.md,规定性格、工作习惯和专业领域。

你扔进去一句:“帮我做一个 SaaS 产品。”

产品经理先梳理需求,设计师开始画界面,前后端互相对接口,QA 最后出来挑刺。几个人还会在群里互相 @,遇到问题讨论两轮,再向你汇报。

第一次看 Demo,很容易冒出一种感觉:

好家伙,我一个人已经带着一家软件公司上班了。

Grok Bot 最近在往这个方向走,Hermes Agent Desktop 的 Bot Mode 也做了类似的东西。后者甚至把 Agent 做成了完整的员工 roster:有名字、有头像、有岗位、有独立聊天窗口,还可以把几个 Bot 拉进群里讨论。

这个产品形态很漂亮。

但我一直有一个疑问:这里面到底增加了多少“智能”?

如果五个员工背后接的都是同一个强模型,只是 system prompt 不同,那么我们究竟组建了一支团队,还是给同一个人发了五张不同颜色的工牌?
阅读全文 »

最近我看到一项很有意思的实验。

研究者找来几个真实、并且还没有公开答案的AI研究课题,让Agent自己查资料、写代码、跑实验、分析结果。他们给了Agent几天时间和相当可观的算力预算,最后再让真正做过这些课题的研究者评价Agent的成果。

结果不太好。Agent没有产出达到论文标准的研究成果。

研究者还分析了大量运行日志,发现Agent有不少问题:一次实验结果不好,它就过早放弃整个方向;不会合理分配预算;Reviewer已经指出关键问题,它还是沿着原来的路线修修补补;遇到死路时,也不知道回退、修改假设、重新设计实验。

这些现象我都相信,而且非常值得研究。

但如果根据这项实验,直接得出“AI Agent现在还不会做开放式研究”,我会非常谨慎。

因为这种实验最终测到的,从来都不只是AI的研究能力。基础模型、Agent框架、工具、实验设计、操作者水平和人类对照组,全都混在最终结果里面。只要其中一个变量没有控制好,结论就很容易超出证据能够覆盖的范围。

阅读全文 »

凌晨两点,你很想找个人说话。

通讯录里不是没人。只是你知道,真正开口以后,大概率还要从头解释:事情为什么会走到这里,你究竟在怕什么,那个别人眼里明明很好的选择,为什么偏偏让你如此抗拒。

解释到一半,你已经累了。

人最深的孤独,往往不是身边没有人,而是没有人能跳过漫长的背景介绍,直接抵达你的那一句「我懂」。

这几年,市面上出现了很多「数字人」产品。最常见的做法,是上传微信聊天记录、朋友圈、语音和照片,再让 AI 学会一个人的口头禅、表情和常用句式。

它可能会模仿你说「哈哈哈哈」,知道你习惯在句尾加一个「吧」,甚至能复述几段你曾经讲过的话。

但会说你的话,不等于会像你一样思考。

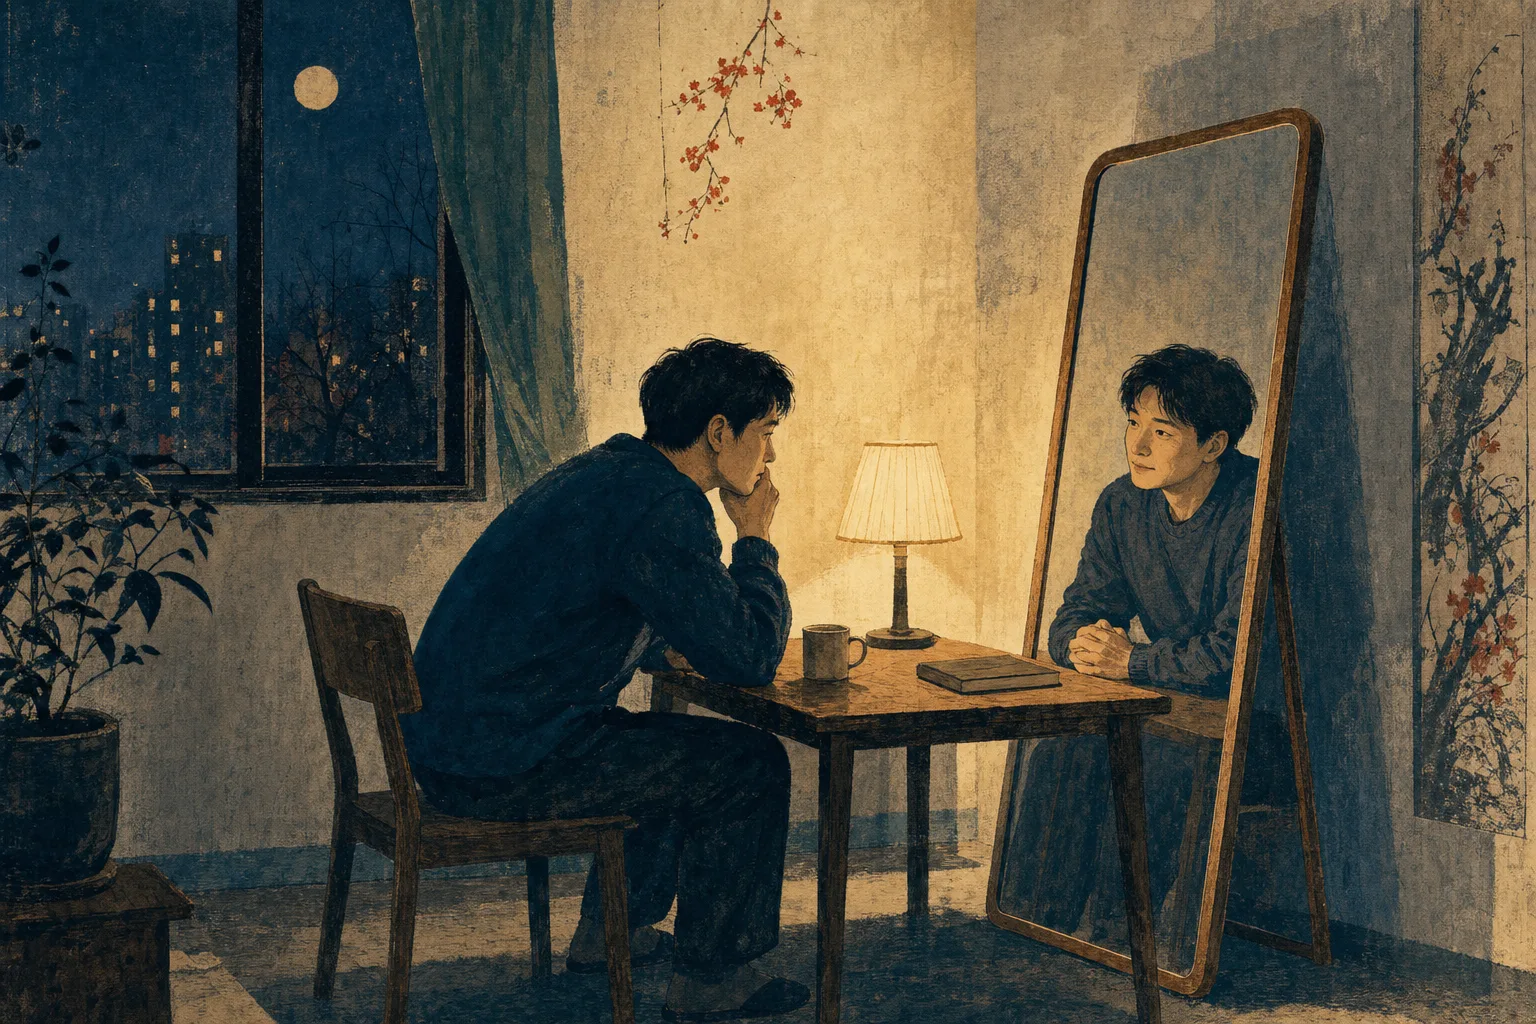
聊天记录复刻的是你留下的回声;镜像星河想做的,是找到发出这道声音的人。

镜像星河:深夜里,现实中的自己与镜中更平静的自己对话

阅读全文 »

昨天,我去逛了一圈世界人工智能大会,也就是 WAIC。

今年的会场里,有一个词几乎无处不在:

Agent。

做大模型的在讲 Agent,做企业服务的在讲 Agent,做招聘、营销、医疗、金融、法律、教育的,也都在讲 Agent。

过去两年,大家还在说自己做的是“大模型应用”“AI 助手”“行业 Copilot”。到了今年,不在产品介绍里加上 Agent,好像都不好意思说自己是一家 AI 公司。

但我在现场和一些公司聊下来以后,产生了一个很强烈的感受:

很多人不只是没有做好 Agent,甚至连 Agent 到底是什么东西,都没有真正想明白。

阅读全文 »

摄影:产品经理

左庭右院蔬菜自助

最近我在看一篇关于电子表格理解的论文。

论文里有一个算法,核心流程其实非常简单:先让一个 Agent 从电子表格中抽取结构,再让视觉 Agent 和 LaTeX Agent 分别验证;如果两边都通过,就返回结果;如果没有通过,就把错误反馈回去,重新抽取,直到成功或者达到最大重试次数。

任何一个写过程序的人,看到这里,大概已经知道代码该怎么写了:

1
2
3
4
5
6
7
8
9
10
for _ in range(max_iterations):
result = extractor.run(spreadsheet, feedback)

vision_check = vision_verifier.verify(result)
latex_check = latex_verifier.verify(result)

if vision_check.passed and latex_check.passed:
return result

feedback = vision_check.feedback + latex_check.feedback

事情就是这么简单。

但论文当然不能这么写。

它非要把这段代码重新包装成一种半数学、半代码、半自然语言的东西:

1
2
3
4
C ← {S, Prompt, Tool interfaces}
Y ← C[-1]
vision_pass, Δv ← parse_verification(Cv[-1])
latex_pass, Δl ← parse_verification(Cl[-1])

再配上各种花体字母、上下标、希腊字母、集合符号和箭头,最后排成一张看起来非常“学术”的算法图。

我盯着这张图看了半天,脑子里只有一个问题:

这到底是在帮助读者理解算法,还是在阻止读者理解算法?

阅读全文 »

在大模型出来之前,计算机领域一直流行着这样一句名言:计算机领域的任何问题,都可以通过拆分问题+给系统增加若干个层来解决。 实际上,这句话在现在的 AI 时代,依然是绝对的真理。

例如以前面试经常问的一个老掉牙的系统设计问题:如何设计一个短网址系统?标准答案是,使用内存+Redis+数据库做多级存储架构。读取最频繁的短网址放到内存,其次的放到 Redis,不频繁的放到数据库。通过增加分层,完美解决高并发和存储成本的矛盾。

现在有了大模型,大家都在玩 Vibe Coding(用自然语言指挥 AI 写代码),很多人觉得以前的工程经验没用了,反正大模型什么都能干。但我认为恰恰相反,在用 AI 写代码时,大家更应该把“拆分与分层”这句话牢牢记在心里。

阅读全文 »

最近在各种AI编程社区里面逛,发现一个很有意思的现象——大家都在疯狂地折腾怎么省Token。

有人搞Prompt缓存,有人换便宜模型,甚至还有人专门写了一个省Token.skill,让大模型在回复的时候尽量精简。更夸张的是,有人为了省钱,把Claude换成了各种开源小模型,然后抱怨说效果变差了。

这些操作,怎么说呢,就像你家水龙头在哗哗漏水,你不去修水龙头,反而跑去超市买打折的矿泉水。

其实真正吃掉你Token的大头,不是大模型的回复太长,也不是你的Prompt写多了。是Skill本身。

阅读全文 »

你一定经历过这个循环:

  1. 打开某个网站,输入你记忆中的密码
  2. “密码错误”
  3. 好吧,点”重置密码”
  4. 邮箱收验证码,输入新密码
  5. “密码必须包含大写字母!”
  6. 行,加了一个大写字母
  7. “不能与之前的密码相同。”
  8. ……

你的记忆力没有问题。 问题出在每个网站的密码规则都不一样:Chase 银行要求 8-32 位、必须有大小写+数字+特殊字符、特殊字符还只能用 ! @ # $ % ^ & * ( );GitHub 要求至少 8 位或者 15 位以上(两套规则);Apple 要求不能有超过 3 个连续相同字符;PayPal 的上限是 20 位……

你根本不是忘了密码,你是忘了这个网站的密码规则是什么

阅读全文 »

最近 OpenAI 发了一篇文章叫 Harness Engineering,讲的是他们内部团队如何用 Codex(基于 GPT-5 的编码 Agent)从零构建一个真实产品的经验。

我读完以后觉得很有启发,不是因为它讲了什么高深的理论,而是因为它非常诚实地记录了一个团队在”让 AI 写全部代码”这条路上踩过的坑和总结出的经验。以下是对我触动最大的几个点。

阅读全文 »

今天突然意识到一个极其本质的问题:为什么目前 AI 还没法真正代替人类做核心决策?

很多人会把原因归结为“算力不够”、“上下文窗口太短”或者“会有幻觉”。但其实根本原因不在于智商,而在于做决策的人,要为结果负责

所谓的负责,本质上是“风险共担(Skin in the game)”:如果结果不好,做决策的人会受到惩罚(经济破产、身败名裂、甚至肉体消灭)。因为害怕这种惩罚,因为有真实的“痛感”,人类才会慎重地权衡利弊。

但 AI 不一样。目前没有任何方式可以真正惩罚一个 AI。你拔掉服务器电源,对它来说无法构成任何威胁,因为它根本不知道什么是“失去”,自然也就没有恐惧。

没有恐惧,就没有权衡;不承担风险,就无法真正负责。

阅读全文 »
0%