让你的字典读取不报错
我们知道,读取 Python 字典时,如果某个 Key 不存在,Python 就会报错,如下图所示:

为了防止它报错,我们可以使用.get()方法:
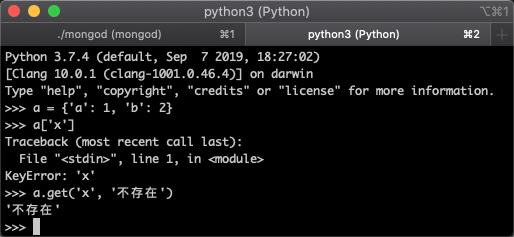
但每次都要写.get()稍显麻烦。于是我们可以通过自己实现一个自定义的字典对象,来解决这个问题。
我们知道,读取 Python 字典时,如果某个 Key 不存在,Python 就会报错,如下图所示:
为了防止它报错,我们可以使用.get()方法:
但每次都要写.get()稍显麻烦。于是我们可以通过自己实现一个自定义的字典对象,来解决这个问题。
在极客时间某设计模式相关的课程中,某老师说 Python 不支持抽象类和接口。
但实际上,Python 支持抽象类。
GeneralNewsExtractor以下简称GNE是一个新闻网页通用抽取器,能够在不指定任何抽取规则的情况下,把新闻网站的正文提取出来。
我们来看一下它的基本使用方法。
经常使用 Linux 的同学,肯定对|这个符号不陌生,这个符号是 Linux 的管道符号,可以把左边的数据传递给右边。
在写 Python 代码时,小括号必定是天天跟我们打交道的符号。无论是函数还是类或是运算优先级都会涉及到大量的小括号。
今天我们来讲讲小括号不为人知的另外两种用法。
我们知道,如果我们在 Python 中想把一段数据持久化到硬盘上,最简单的办法就是写文件:
1 | with open('data.txt', 'w', encoding='utf-8') as f: |
但这样做有一个弊端,就是在读取数据的时候,我们把整个数据读入内存以后,还需要单独写一段代码,用来区分哪里是username对应的值,哪些是password对应的值。
二十几种设计模式中,单例模式是最简单最常用的一种。在其他语言里面实现单例模式要写不少代码,但是在 Python 里面,有一种非常简单的单例模式写法。
在上一篇文章中,我们说到了,itertools.tee不是线程安全的,并给出了一个例子,如下图所示:
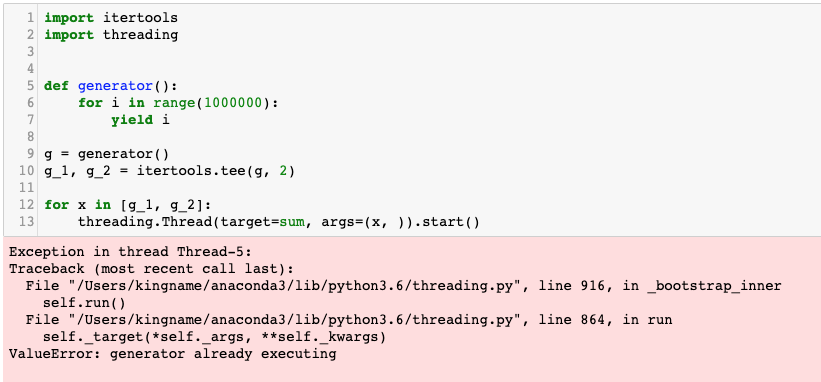
在两个线程里面同时运行分裂出来的生成器对象,就会导致报错。
在上一篇文章中,我们讲到了,使用itertools.tee可以让一个生成器被多次完整遍历:
1 | import itertools |
但是,我们说到itertools.tee有两个弊端,其一,如果分裂出来的多个生成器是按顺序执行的,其中一个完整遍历了再遍历第二个,那么就会导致内存中堆积大量的数据。
要解释这个问题的原因,我们就要理解itertools.tee背后的原理。
我们知道,Python 里面的生成器只能被消费一次,例如如下代码:
1 | def name_generator(): |
运行效果如下图所示:
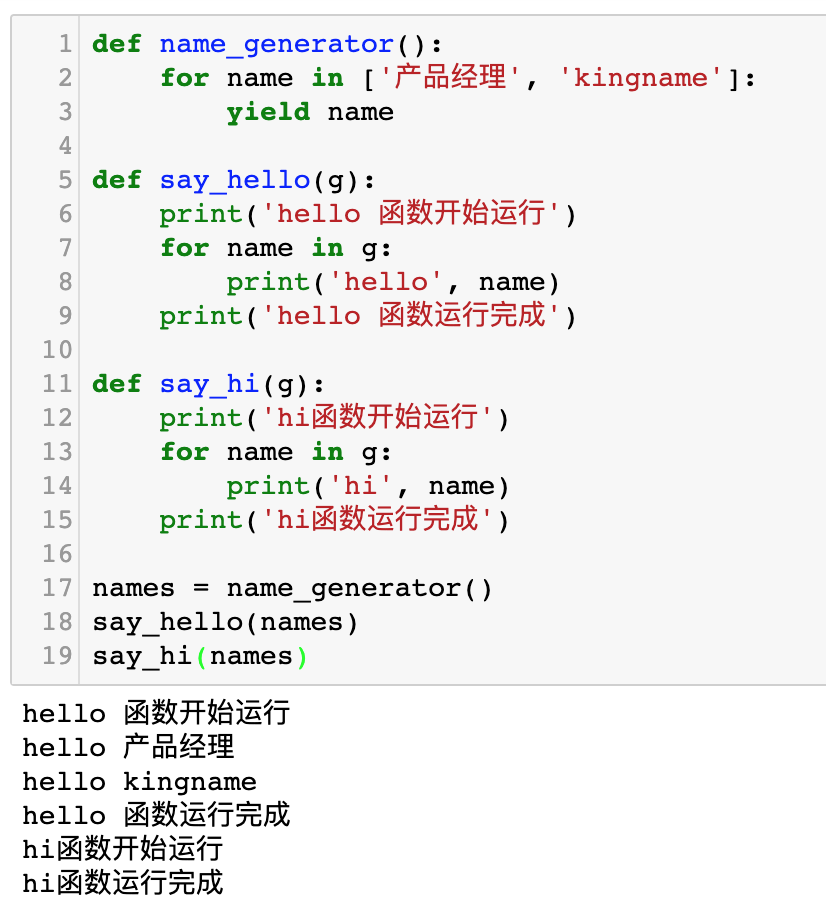
在 say_hello函数里面,生成器已经被完整遍历了一次,那么在say_hi里面,就什么数据都拿不到了。
但如果我们用的是列表,就可以多次遍历,如下图所示:

大家注意观察区别。
那么有什么办法,能让生成器被多次完整迭代呢?这个时候就要使用itertools.tee这个函数了。它通过dequeue实现了让生成器多次消费的办法。